Een research pipeline voor wat het internet wel laat zien
Ik heb een research pipeline gebouwd om een Nederlandse e-commerce niche te kiezen om in te lanceren. Versie 1 wees me er één aan. Ik heb daar een webshop op gelanceerd, één verkoop gedaan, en de shop weer dichtgegooid om redenen die de pipeline op geen enkele manier kon zien. Versie 2 is strikter opgezet en ik vertrouwde hem minder, omdat ik tegen die tijd had geleerd welke laag van het probleem een pipeline als deze niet raakt.
Het is een 5-staps pipeline — crawl, classify, embed, cluster, analyze — die ongeveer 177.000 Nederlandse e-commerce domeinen verwerkt en een gerankte lijst van niches oplevert die eruitzien als blinde vlekken: veel zoekvolume of bekende categorie-omzet, schaars online aanbod. Dat is wat ik hem heb gevraagd te vinden, en op zijn eigen termen heeft hij die gevonden. De niches waren echt en er viel een werkende shop op te bouwen op basis van de output — de pipeline deed precies de klus die ik hem had gegeven. Wat de pipeline op geen enkele manier kon laten zien, was de operationele laag onder de niche, en dat is waar het eerlijke verhaal van dit project ligt: e-commerce- en dropshipping-werk rond zo’n niche is ellendig, de marge relatief klein, en zodra ik een echte shop had gelanceerd en van dichtbij had gezien wat voor soort service ik aan een klant zou leveren, had ik geen zin meer om hem te draaien — hoe schoon de ranking ook was geweest.
De grote lijn
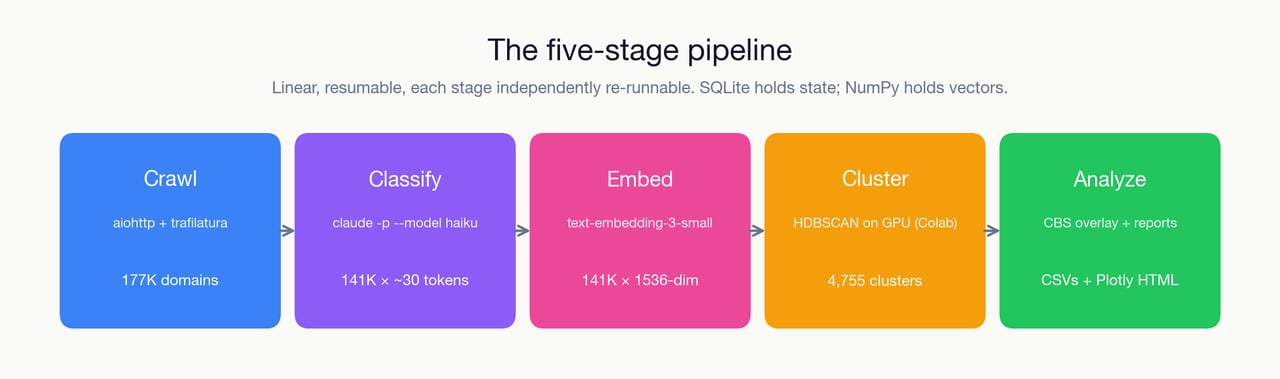
De bron is niet het open web. Het is de output van twee eerdere projecten van mij — eentje die de Nederlandse domeinruimte in kaart bracht voor onderzoek, en eentje daar bovenop die de lijst terugfilterde tot de domeinen waar waarschijnlijk een e-commerce store op draait. Ongeveer 177K daarvan, die in MongoDB stonden tegen de tijd dat deze pipeline begint te lezen. De pipeline crawlt niet vanaf nul — hij verwerkt een gecureerde lijst.
De classifier is Claude Haiku, één call per domein, met async concurrency gecapt op ongeveer tien in-flight calls. De kosten per call op die schaal waren laag genoeg dat het opnieuw draaien van het hele corpus over verschillende versies van de pipeline nooit een budget-discussie werd.
De embeddings zijn OpenAI’s text-embedding-3-small, 1536-dimensionaal, toegepast op de classification text (industry + niche + products + keywords + USPs) in plaats van de ruwe HTML van elke crawl. De embedding-dataset kwam uit op ongeveer 141K × 1536 op float32.
Clustering is HDBSCAN op een 20-dimensionale PCA-projectie. Ik begon het lokaal op CPU te draaien, en op de volledige corpus-grootte was de run zo traag dat hij onbruikbaar werd — de CPU stond uren te thrashen en gaf me nog steeds geen clustering waar ik in één sessie op door kon werken. Dus de run die nu echt telt, draait op Google Colab via cuML RAPIDS GPU. De lokale CPU-clustering-code staat nog in de codebase, maar ik draai die feitelijk nooit op volledige corpus-grootte — die wordt alleen aangeroepen voor kleine test-subsets. Het echte pad is een .npz round-trip via een Colab-notebook, wat betekent dat de pipeline eigenlijk geen single end-to-end command is — de clustering-stap gebeurt off-machine, en de rest van de pipeline moet daarnaartoe overdragen en het resultaat weer oppikken.
Tot slot, kansen-scoring op cluster-niveau. Cluster-keywords worden gematcht tegen Nederlandse SBI-codes, en daarna gejoind aan de CBS (Centraal Bureau voor de Statistiek) OData API voor een omzetindex per sector en jaar-op-jaar groei. De output is een CSV met gerankte “dropshipping opportunities”, gesorteerd op een gap-score. Een getal, gezaghebbend ogend, en ik kom nog terug op wat het wel en niet waard is — niet in de laatste plaats omdat ik de SBI/CBS-helft uiteindelijk helemaal niet gebruikt heb om een niche te kiezen. In de praktijk behandelde ik de clustering-output als ideegeneratie en hield ik daar op met de pipeline. Ik liep elke kandidaat-niche met de hand af en checkte adverteerdersactiviteit op Meta en Google; of er iets serieus op een van beide platforms draaide, was wat mij vertelde dat een niche echt gewicht achter zich had, naast het voor de hand liggende filter of het iets was waar ik echt mee aan de slag wilde.
Waar V1 me naartoe stuurde, en wat er gebeurde
V1 van de pipeline was een kleinere setup — lokale MiniLM embeddings op ruwe pagina-content, CPU-clustering op kleinere schaal, geen CBS-overlay. Hij leverde een gerankte shortlist op, ik koos daar een niche uit, en ik bouwde er een echte webshop omheen. De shop deed één verkoop en ik trok hem binnen een maand offline.
De reden dat hij eraan ging, zat in de operatie, niet in de niche-keuze. Het was een dropshipping-business op gepersonaliseerde items die in China gemaakt werden, wat betekende dat de verzendtijden lang genoeg waren dat mijn eerste en enige klant al klaagde over de levering voordat iets anders überhaupt de kans kreeg om mis te gaan. De vorm van de daaropvolgende maanden was vanaf dat moment duidelijk: het meeste van mijn tijd zou opgaan aan klantenservice-mails over verzending, en bijna niets aan het daadwerkelijk doorontwikkelen van de shop. Ik schrijf dat project apart op als zijn eigen post-mortem; voor deze post is het verhaal gewoon: de output van de pipeline was bruikbaar, en ik heb erop gehandeld. De pipeline heeft me niet de verkeerde niche aangewezen. Hij wees me een niche aan waarbij het ding dat me zou opvreten — de operationele laag onder de website zelf — niet iets was wat een pipeline van deze vorm kon meten. Dat bleek een nuttiger stuk leerwerk dan wat de CSV me ooit had kunnen geven. Lang genoeg een echte shop draaien om te zien waar mijn dagen écht aan opgingen, deed het inzicht inklikken dat ik niet in e-commerce wilde zitten — niet de markt, maar de dagelijkse praktijk van het draaien van een shop. Welke marge een goede niche ook maar zou kunnen opleveren, het werk dat bij het runnen van het ding hoorde, ging me ongelukkig maken, en ongeveer een maand het echt doen was de goedkoopste eerlijke manier om daarachter te komen.
Dat is de dragende zet waar de rest van deze post op rust. De pipeline was niet stil vanwege een bug. Hij was stil omdat het ding waar hij naar keek — wat er op het internet staat, geaggregeerd, in het Nederlands — een ander object is dan het ding dat bepaalt of een specifieke operator een specifieke shop winstgevend kan draaien. Fulfillment, unit economics, de dagelijkse praktijk van het draaien van een bepaalde categorie — niets daarvan komt naar boven in een embedding van een gecrawlde homepage.
Waarom V2 strikter was en ik hem minder vertrouwde
V2 was, technisch gezien, beter op elke dimensie waarop ik hem beter wilde maken. Meer domeinen in het corpus. OpenAI-embeddings op classification text in plaats van lokale MiniLM op ruwe HTML, wat een hoop footer-boilerplate-ruis wegsneed en clusters opleverde die ik daadwerkelijk kon lezen. HDBSCAN op cuML GPU in plaats van een CPU die uren stond te thrashen. Een CBS-overlay die elk cluster scoorde tegen publieke omzet- en groeicijfers — al weet ik nog steeds niet zeker of dat laatste de output echt verbeterde of er gewoon gezaghebbender uit liet zien. Op elke metric die ik voor de rewrite had gezet, was V2 de versie die de pipeline had moeten zijn.
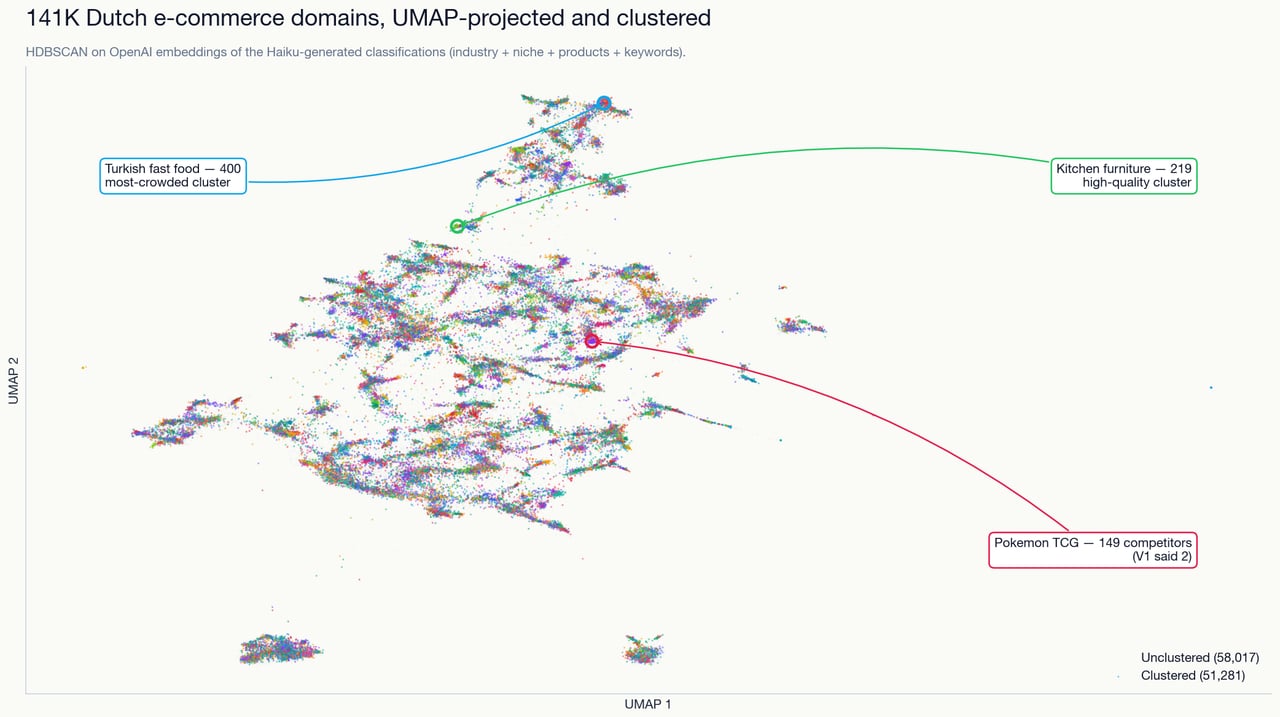
En de hoofdbevinding van V2 was dat V1 op meerdere plekken zelfverzekerd fout had gezeten. Het duidelijkste voorbeeld is Pokemon TCG. V1 was teruggekomen met 2 concurrenten in het cluster — een gat, een wijd open niche, nú gaan. V2 kwam terug met 149, inclusief feitelijk elke gevestigde kaartwinkel in het land. Dezelfde markt, dezelfde pipeline-vorm, andere embedding en andere schaal, een totaal ander concurrent-aantal.
Die correctie had het moment moeten zijn waarop de pipeline méér van mijn vertrouwen verdiende, niet minder. V2 was het instrument dat zichzelf corrigeerde, en dat is precies het gedrag dat je uit een onderzoekstool wilt. Het probleem was dat ik al sceptisch was voordat V2 het me vertelde. Een vriend van mij zit toevallig in de Nederlandse TCG-markt, en hij had me eerder al — op de meest low-tech manier denkbaar, een gesprek — verteld dat die markt een stuk groter was dan V1’s output suggereerde. Dus toen V2 terugkwam met 149, was dat geen openbaring. Het was de pipeline die alsnog inhaalde wat ik weken eerder al wist uit een gesprek met één iemand die de categorie kende.
Dat is geen vleiend datapunt voor 141K × 1536-dimensionale embeddings. Eén gesprek met één vriend leverde een accuratere lezing van de Pokemon TCG-concurrentie op dan V1 deed, en V2’s overeenstemming met die vriend bekrachtigde alleen maar een beeld dat ik al had. De rol van de pipeline in die specifieke niche was retrospectief: hij kwam uiteindelijk op het juiste antwoord uit, lang nadat ik het juiste antwoord ergens goedkoper al had.
Ik wil niet hard generaliseren vanuit één datapunt. Maar ik heb in de output van V2 nooit een niche gevonden waar ik onafhankelijke ground truth op had en waar de pipeline vóór die ground truth zat. Tegen de tijd dat ik echt iets geloofde over een niche, kwam dat ergens anders vandaan — een vriend, een forum, een markt waar ik al naast leefde — en zat de pipeline daar dan mee in te stemmen of het tegen te spreken tegenover een beeld dat voor mij leesbaarder was dan dat van de pipeline. De eerlijke voetnoot bij dit hele project, de voetnoot die de codebase je niet zal vertellen, is dat ik geen bewust protocol heb opgezet om een kandidaat-niche te valideren tegen een mens in de markt. Ik had één toevallig datapunt, en dat landde laat genoeg om de toon voor de rest van de runs te zetten in plaats van vroeg genoeg om het ontwerp van de pipeline zelf om te buigen.
Dingen die ik bij een rewrite eruit zou snijden
Er zijn een paar concrete dingen in de repo die ik zou weghalen als ik er met frisse ogen op terug zou komen.
Drie parallelle embedding-pipelines — OpenAI op classification text, lokale MiniLM op ruwe HTML, en een derde die alleen op domeinnamen draaide — zijn naast elkaar blijven bestaan, elk geïntroduceerd om een ander probleem met de vorige op te lappen. Alleen het OpenAI-pad is daadwerkelijk dragend voor de rest van de pipeline. De domeinnaam-pipeline produceerde zijn eigen retro-document waarin werd toegegeven dat het tokeniseren van Nederlandse second-level domains met een Nederlandstalig BERT-model de clusters slechter maakte in plaats van beter (de top-cluster-keywords waren dingen als “dam”, “ster”, “min”, “mijn”, “van” — dus substrings van domeinnamen, geen onderwerpen). Bij een rewrite zou ik één embedding-pad kiezen en de andere twee weghalen.
De CBS SBI keyword-match-scoring — de laatste stap van de pipeline, degene die de top-keywords van een cluster pakt, probeert die te koppelen aan een Nederlandse SBI-code, en die code vervolgens joint tegen CBS-omzet- en groeicijfers om tot de uiteindelijke kansen-ranking te komen — doet minder werk dan het lijkt. Die keyword-naar-SBI-match is zelf een keyword-overlap-heuristiek, en die heuristiek is onnauwkeurig genoeg om tandartspraktijken aan hotels te koppelen als je hem zijn gang laat gaan. Er staat een match_score >= 3-filter overheen om de ergste gevallen weg te knippen, maar er is geen evaluatie van hoe vaak dat filter goede matches op de grond laat vallen. De kansen-score zelf is een gewogen combinatie van vijf subscores — concurrentie, kwaliteit, e-commerce-ratio, fysieke-goederen-ratio, dropship-vriendelijkheid — met wegingen van 0.25 / 0.20 / 0.20 / 0.15 / 0.20. De gap-score tussen cluster-vraag en cluster-aanbod is (revenue_index * growth_factor) / sqrt(cluster_size). Beide formules ogen gezaghebbend. De wegingen in de eerste zijn nergens in de repo onderbouwd. Het zijn vibes. De tweede is een plausibel ogend onderbuikgevoel met een vierkantswortel erin. Wat in de praktijk allemaal niet veel meer uitmaakte, want ik ben gestopt met op deze stap te leunen om een keuze te maken zodra het duidelijk werd hoe onnauwkeurig hij was — de tandartspraktijk-naar-hotel-mismatch is het soort ding dat bleef opduiken, en vanaf dat moment behandelde ik de output als achtergrondruis in plaats van signaal en maakte ik de feitelijke keuzes op basis van de clustering-output plus de handmatige adverteerderscheck die ik hierboven beschreef.
De hybride embedding waarvan ik al wist dat ik die zou moeten gebruiken, heeft het nooit gehaald. Een 0.5 * raw_page + 0.5 * classification-blend was de voor de hand liggende fix geweest voor het probleem dat “classification-text-only gegijzeld is door de classifier” — ik had voor mezelf een notitie liggen waar precies dat in stond, en ben er vervolgens nooit op teruggekomen om het te implementeren. Tussen aanpakken die ik al had besloten beter te zijn en aanpakken die ik daadwerkelijk had gedraaid, is de ratio van de eerste tot de tweede in deze codebase hoger dan waar ik comfortabel mee ben.
Er zijn ook nul tests. De correctheid van de pipeline werd gevalideerd door de output-CSVs te lezen en “ja, dat ziet er goed uit” te denken. Dat is precies de manier waarop V1 me dingen had laten geloven die V2 later weer terugnam — hij produceerde output die er goed uitzag, en er stond niets tussen die output en het mij geloven dan mijn eigen pattern-matching.
Wat ik mee zou nemen naar het volgende
Eerlijk gezegd niet zo heel veel dat generaliseert. Haiku was het juiste model voor dit soort structured-extraction-over-een-groot-corpus-werk — goedkoop per call, nauwkeurig genoeg op het classification-schema om de downstream clustering iets schoons te geven om mee te werken, en vergevingsgezind voor het feit dat elke input een rommelige gecrawlde homepage was in plaats van een netjes voorbereide prompt. Als ik in de nabije toekomst tegen een ander large-batch-classification-probleem aanloop, zou ik bij Haiku beginnen, en ik zou ook een tier eronder willen testen om te zien waar de accuracy cliff feitelijk zit — voor dit soort werk is het plausibel dat iets goedkopers dan Haiku al goed genoeg is, en dat experiment heb ik nooit gedraaid. De richting die ik wel heb geprobeerd en die niet werkte, was de andere kant op: ik heb een Runpod-instance opgezet met DeepSeek R1 tegen dezelfde classification prompt, en die was slechter op elke as die ik belangrijk vond — langzamer per call, merkbaar duurder om te draaien, en de extra reasoning tokens leverden geen extra nauwkeurigheid op voor een taak die feitelijk gestructureerde extractie uit een gecrawlde homepage is. Voor dit soort probleem wordt het plafond niet bepaald door hoe slim het model is. Het wordt bepaald door hoe schoon de input is en hoe strak het output-schema is afgebakend. Daarbuiten is de rest van de pipeline te zeer verbonden met déze niche-hunt in deze markt om netjes mee te nemen naar iets anders.
Waar het nu staat
Het project staat geparkeerd. De laatste echte run is van half maart, en er zijn sindsdien geen betekenisvolle commits geweest. Het is niet dood — ik heb de repo niet verwijderd, en er ligt geen specifiek besluit om hem te killen — maar er wordt ook niet actief aan gewerkt, en ik heb geen directe plannen om hem weer open te trekken.
Als ik hem wel weer zou openen, is het enige eerlijke pad om hem te shippen als een Nederlandse market-intelligence SaaS voor andere operators — iets dat de clustering-output, de classifier-pipeline, en een opgeschoonde versie van de CBS-overlay pakt en die in een UI wikkelt waar iemand anders dan ik voor wil betalen. De insteek zou ideegeneratie zijn in plaats van een gerankte kansen-lijst: hier zijn leesbare clusters van de Nederlandse markt, hier is ruwe omzet- en groei-context op sectorniveau, doe nu zelf je validatie — want een niche moet bij de specifieke operator passen voordat iets ervan werkt, en CBS-data is breed genoeg dat een goed verdienende sector nog steeds hoge opstartkosten of een operationele puinhoop kan verbergen die de cijfers niet laten zien. De keyword-naar-SBI-mapping zoals die er nu staat, zou niet de versie zijn die de deur uit gaat; het idee erachter klopt, de manier waarop ik het heb geïmplementeerd niet. Ik ben dat pad niet ingeslagen omdat er nog geen klant voor is, en de enige klant die de CSVs nu hebben ben ik, en ik koop het niet.
Als jij iets bouwt dat hiernaast ligt — een market-intelligence-pipeline, een large-batch LLM-classification-job over een rommelig corpus, of een retrospectief op een onderzoekstool die uiteindelijk meer goede vragen dan antwoorden produceerde — wissel ik graag notes uit.
Lees ook
-
Een diamond-painting-webshop die de code niet kon redden
Begin 2026 gelanceerd, één verkoop, binnen een maand dicht. De Chinese leverancier had weken doorlooptijd en loog over de verzendkosten waarop ik prijsde.
-
Een agent gebouwd rond het niet aanroepen van de LLM
De meeste agent frameworks roepen het model standaard nog een keer aan. Dit project doet het tegenovergestelde, en de architectuur volgt daaruit.
-
Introductie
Eerste post. De blog gaat over productiesystemen, data-science-onderzoek, en onafhankelijke software-experimenten — drie werkmodi, niet drie projecten.