ta v2.0.0: drie libraries op één audited spec
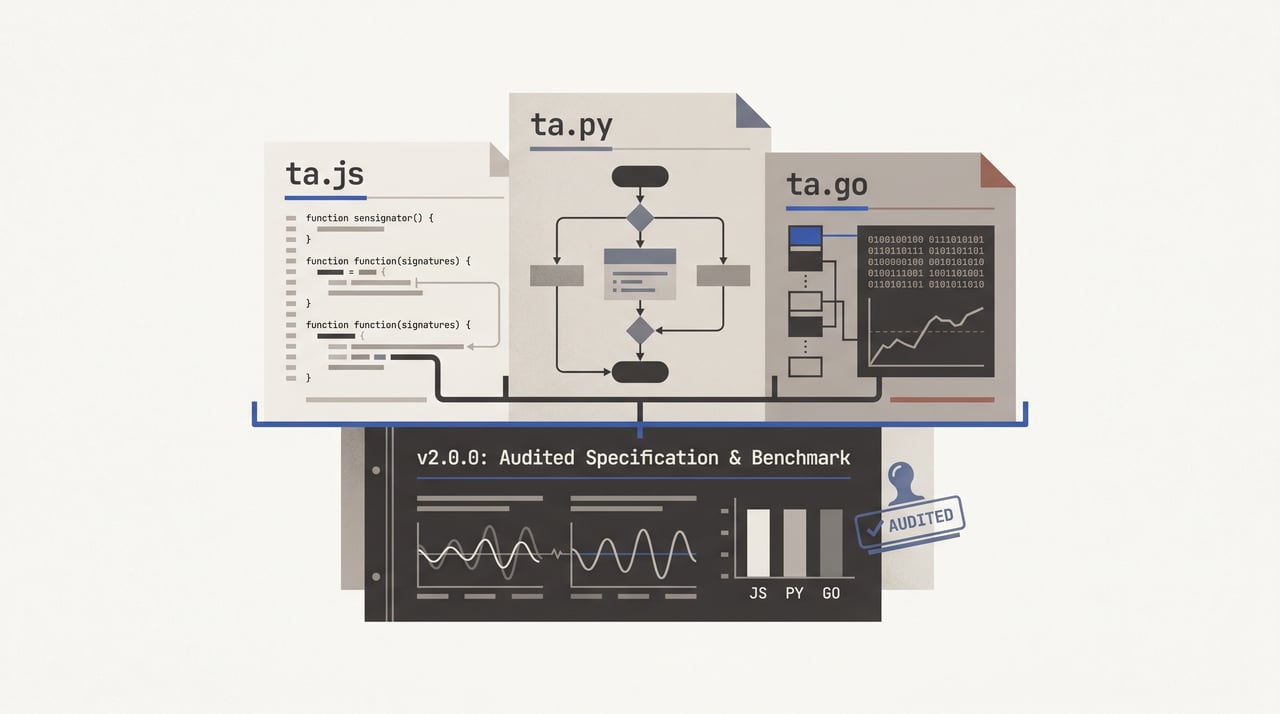
Twee weken geleden is ta v2.0.0 uitgebracht — over alle drie de libraries tegelijk. ta.js, ta.py en ta.go zijn alle drie naar dezelfde major version gegaan op dezelfde release cut, met dezelfde honderd-en-zoveel indicator-functies end-to-end geaudit tegen leerboek-formules en met een vergelijkende benchmark in elke taal tegen de libraries waar die specifieke implementatie daadwerkelijk mee concurreert. De reden dat het één version bump is in plaats van drie aparte version bumps, is dat de libraries de laatste paar jaar genoeg uit elkaar waren gegroeid dat ze los van elkaar fixen zou hebben betekend dat ik dezelfde indicator drie keer zou fixen en het alignment-werk daarna alsnog moest doen. Dus dat alignment-werk heb ik eerst gedaan.
De correctheid en snelheid van een technical-analysis library zouden over talen heen moeten reizen, niet alleen een JS-only verhaal moeten zijn. Dezelfde geauditeerde indicators, dezelfde vergelijkende benchmark-methodologie, dezelfde zero-dependency-houding. ta.js, ta.py en ta.go zijn het nu eens over wat een RSI hoort terug te geven, en elk van de drie is gemeten tegen de libraries waar je in die ecosysteem ook daadwerkelijk tegen zou benchmarken.
Ik heb eerder geschreven over de v1.17.0 moderniseringsronde op ta.js — de source-layout-opschoning, de esbuild bundle-pipeline, de registry-indirectie die het override-patroon behoudt. v2.0.0 is het volgende hoofdstuk van diezelfde library, en het hoofdstuk waarin de libraries in de andere talen eindelijk meekomen op een gedeelde specificatie.
De vorm
Drie repositories, één library-familie. ta.js voor JavaScript, ta.py voor Python, ta.go voor Go. De repos staan op github.com/Bitvested/ta.js, github.com/Bitvested/ta.py en github.com/Bitvested/ta.go. Over alle drie heen is het indicator-oppervlak hetzelfde: moving averages, oscillators, bands, volatility-indicators, statistics, chart transforms, rond de honderd functies per library, elk kort genoeg om in één keer door te lezen.
Wat v2.0.0 in eenvoudige termen daadwerkelijk oplevert:
-
Een indicator-voor-indicator audit tegen de standaard leerboek-formules, met formule-bugs over alle drie de implementaties heen opgespoord en gefixt.
-
Een vergelijkende benchmark per library, waarbij elke implementatie wordt vergeleken met de libraries die in dezelfde ecosysteem met haar concurreren.
-
Een bench-harness die in elke repo meekomt en bedoeld is om door iedereen die de cijfers wil verifiëren opnieuw gedraaid te worden — hardware vastgelegd, concurrent-versies gepind.
-
Dezelfde zero-runtime-dependency-houding die de libraries vóór v2.0.0 ook al hadden, behouden als harde familiebrede constraint. Geen van deze libraries trekt op runtime een third-party binnen, in geen enkele taal.
De audit was de onglamoureuze helft
Het startpunt van v2.0.0 was dat ik moest erkennen dat de v1 test suites — over alle drie de libraries, maar het meest gênant in ta.js — me eigenlijk niet vertelden of de indicators correct waren. De fixtures waren gegenereerd vanuit de implementaties zelf op het moment dat die implementaties geschreven waren. Als de implementatie toen fout was, dan is de fixture nu fout, en stelde de test niets meer vast dan “de verkeerde output is stabiel verkeerd.” Ik ben ta.js in 2020 begonnen toen ik indicator-functies voor mijn eigen werk nodig had en ze elk zelf schrijven was de schoonste manier om ze te leren. Sommige van de indicators die ik in die eerste drie weken schreef horen bij wat de audit ving.
Zes indicators in ta.js kwamen terug met formule-bugs die in de fixtures gefossiliseerd waren: parabolic SAR, k-means clustering, de Wilder smoothed moving average, ichimoku, momentum oscillator en fractals in price-mode. De smoothed moving average was het schoonste voorbeeld van het patroon. De v1-formule was dimensioneel verkeerd, de fixture was vastgelegd vanuit de verkeerde formule, en een groene test-suite had het verkeerde antwoord jarenlang als correct gecertificeerd. De gecorrigeerde implementatie is kort genoeg om in één oogopslag te lezen:
function smma(data, length=14) {
  const n = data.length;
  if (n < length) return [];
  let seed = 0;
  for (let i = 0; i < length; i++) seed += data[i];
  let prev = seed / length;
  const out = [prev];
  for (let i = length; i < n; i++) {
    prev = prev + (data[i] - prev) / length;
    out.push(prev);
  }
  return out;
}
Een length-N SMA-seed, en daarna een Wilder rolling update van prev + (data[i] - prev) / length voor de rest van de serie. Diezelfde fix is in ta.py en ta.go geland, omdat dezelfde kapotte formule in alle drie zat. Het lezen van de audit-notities naast de fixtures is wat me deed beseffen dat de suite zelf het probleem was, niet de indicators die de suite niet wist te markeren.
Ik schaamde me er een beetje voor maar het zit me eigenlijk niet zo dwars. Deze zes zijn van de eerste ta.js-indicators die ik ooit heb geschreven, en ik ben sindsdien gegroeid. Ik ben blij dat ik ze nu allemaal heb gevangen. Vóór de audit wist ik al dat er issues zouden zijn die nooit gevangen waren — dat is het soort ding dat je alleen ziet door elke functie naast een leerboek te lezen, en dat is niet het soort pass dat je terloops doet. Het is het soort pass dat je doet zodra je hebt besloten de versie clean te breken.
De cross-language reikwijdte van de audit was het stuk dat ik niet had aangevoeld. ta.py’s rsi, bijvoorbeeld, was Cutler RSI aan het berekenen — een strict sliding window van de laatste length-1 delta’s — waar het leerboek (en de gecorrigeerde ta.js) Wilder smoothing gebruikt, geïnitialiseerd met het gemiddelde van de eerste length raw gains en losses. Dezelfde indicator-naam, twee verschillende algoritmes, allebei groen tegen fixtures die uit zichzelf waren vastgelegd. De fix is in ta.py geland met een MIGRATION.md-entry, en ta.py’s wrsi is nu een dunne alias voor rsi zodat de legacy callers nog resolven.
De audit ging zo snel als het ging omdat ik agentic coding tools had die het proeflezen en het kruisverwijzen voor me deden, werk dat ik anders één indicator per keer met de hand tegen het leerboek had moeten doen. Drie libraries aan formule-auditing, regel voor regel, zou anders weken hebben gevreten. Met die hulp paste het werk in één release-shaped venster waarin ik alle drie de implementaties tegelijk in mijn hoofd kon houden, en dat is de enige reden waarom de multi-language scope op een solo-tijdlijn haalbaar was.
De bench was de verrassende helft
Toen de audit klaar was en elke indicator gaf wat het leerboek zegt dat het moet geven, was de volgende voor de hand liggende vraag hoe de library eigenlijk presteerde tegen haar concurrenten. Voor zover ik heb kunnen vinden bestaat er geen breed geaccepteerde vergelijkende benchmark voor technical-analysis libraries in geen van deze drie talen met genoeg gestrengheid rond hardware-specificatie en concurrent-versies om reproduceerbaar te zijn. Ik wilde de library meetbaar maken tegen iets anders dan de eigen internals.
Voor ta.js was de vergelijkings-set de vanzelfsprekende: technicalindicators 3.1.0, trading-signals 7.4.3, @debut/indicators 1.3.22 en tulind 0.8.20. De eerste drie zijn pure-JavaScript libraries; tulind is een Node-binding naar een C-library. tulind heb ik er bewust ingezet. De praktische vraag die een developer stelt bij het kiezen van een library is “moet ik de native bindings installeren voor de snelheid?” en de enige manier om die vraag eerlijk te beantwoorden is om de vergelijking daadwerkelijk te draaien.
Het resultaat was dat pure-JS ta.js 66 van de 67 cross-library cases won bij 100.000 bars op een Apple M3 met Node v25.1.0, inclusief tegen tulind. De resterende — Rate of Change — zit op 100k zo’n 22% achter @debut/indicators, een constant-factor-gat dat ik nog niet heb dichtgereden en dat ik in een latere ronde oppak. De rest van het veld zit comfortabel daarachter. Ik had min of meer verwacht dat de C-bindings zouden verliezen bij de groottes waarop een echte workload draait — de FFI-marshaling-kost wordt eenmaal per call betaald ongeacht hoeveel rekenwerk de call doet, dus naarmate het werk per call groeit, stapelt de C-tax zich tegen zichzelf op — maar ik had niet verwacht dat de winst zo allesomvattend zou zijn over de rest van het veld. De cijfers zijn quoteerbaar op dezelfde hardware. Verhoudingen reizen tussen machines, absolute ops/sec doen dat niet. De volledige tabel staat op BENCHMARKS.md en de reproductiestappen in bench/README.md.
De Python-bench is waar v2.0.0 erachter kwam dat het zichzelf een schoner verhaal vertelde dan het werk eigenlijk dekte. Ik bouwde de ta.py-benchmark in de verwachting dat de library competitief zou zijn tegen de C-bound Python-opties op dezelfde manier als ta.js was tegen tulind. Dat was het niet. De C-bound Python-libraries waren ruwweg honderd keer sneller dan pure-Python ta.py. Dat was een tegenvaller, en die heb ik in mijn eigen notes als zodanig opgeschreven voordat ik wist wat ik ermee aan moest.
Wat ik achteraf bedacht, is dat de vergelijking eigenlijk niet eerlijk was. ta.py is per ontwerp een pure-Python library, en de zero-runtime-dependency-houding is een familiebrede constraint, geen per-taal voorkeur. C-bindings toevoegen zou ta.py niet sneller hebben gemaakt op haar eigen termen; het zou de library hebben veranderd in een wrapper rondom andermans C-library, wat niet de library is die het wil zijn.
De concurrenten die in de bench gepind staan zijn TA-Lib 0.4.28, pandas-ta 0.3.14b en finta 1.3 — één Python-wrapper rondom een C-library, en twee NumPy/pandas-backed implementaties die hun hot loops naar NumPy’s C-internals duwen. Er bestaat geen breed-gebruikte pure-Python TA-library in de Python ecosysteem waar ik ta.py naast kan zetten zoals ta.js naast technicalindicators of trading-signals zit. De framing dus — dat de juiste as om ta.py op te meten pure-Python-tegen-pure-Python is — is een houding, geen gebenchmarkte claim tegen een benoemd veld. Wat de bench in de repo ta.py daadwerkelijk tegen meet is het NumPy/C-backed veld waarvan de framing al toegeeft dat het verliezen verwacht, plus een interne naïeve leerboek-baseline die de sliding-window-herschrijvingen moeten verslaan. De bench-methodologie en de gepinde concurrenten staan in bench/README.md; per-run resultaten-tabellen worden bewust niet gecommit, omdat absolute cijfers niet generaliseren over machines en de README van de bench daar zelf expliciet over is.
Ik ben niet aan de Python-bench begonnen vanuit een principiële “vergelijk alleen tegen pure-Python libraries”-houding — ik verwachtte dat ta.py competitief zou zijn tegen alles in de ecosysteem, kreeg de C-bound cijfers, en pas daarna ben ik teruggelopen naar de framing hierboven. Als je maximale snelheid in Python nodig hebt en bereid bent een C-dependency aan te nemen, dan zijn de C-bound libraries nog steeds het antwoord. ta.py is het antwoord wanneer je dat niet kunt of niet wilt.
ta.go volgde hetzelfde patroon als ta.js — pure Go, vergeleken tegen de pure-Go alternatieven in de ecosysteem, geen FFI-fratsen. De vergelijkings-set was markcheno/go-talib (gepind aan een build uit januari 2025, omdat er geen semver-tag voor bestaat) en cinar/indicator 1.3.0. Beide zijn pure Go — go-talib, ondanks de naam, is een Go-port van TA-Lib en niet een CGO-wrapper, en dat is de reden waarom de bench schoon draait met CGO_ENABLED=0. De bench leeft in een aparte go.mod binnen de repo zodat die benchmark-deps niet lekken naar iemands go.sum als hij ta.go zelf installeert; de gepubliceerde tabel staat op bench/BENCHMARKS.md en de reproductiestappen op bench/README.md.
Het resultaat was dat pure-Go ta.go op 100k bars elke cross-library case wint of gelijkspeelt. Tegen markcheno/go-talib — de pure-Go port van TA-Lib, en dus de moeilijkere van de twee vergelijkingen — is ta.go sneller op SMA (1.30×), MACD (1.18×), Bollinger Bands (1.25×) en ATR (1.90×), en binnen run-to-run ruis op EMA en RSI. Tegen cinar/indicator wint hij elke indicator regelrecht, met het grootste verschil op RSI bij 3.51× en het kleinste op Bollinger bij 1.34×. De ene uitschieter in de tabel is de 10k Bollinger-regel, waar ta.go trager is dan beide concurrenten: go-talib slaat de rijen vóór de warm-up bar over en geeft alleen de post-warm-up reeks terug, terwijl ta.go en cinar allebei de volledige n-l+1-rijige serie teruggeven. Die extra boekhouding telt zwaarder op 10k dan op 100k, waar de vergelijking omklapt en ta.go ook op Bollinger weer de snelste is. Die regel staat eerlijk in de tabel in plaats van eruit geveegd — het is ta.go’s tegenhanger van het Rate of Change-gat op ta.js, een klein constant-factor item dat ik liever rapporteer dan verberg.
Drie libraries, één release
De reden dat v2.0.0 over drie repositories op hetzelfde versienummer uitkomt, is dezelfde reden waarom de audit en de bench de moeite waard waren om überhaupt te doen. Ik heb altijd geprobeerd deze libraries op één lijn te houden — wat ta.js sma noemt zou dezelfde functie moeten zijn als wat ta.py sma noemt, met dezelfde default parameters en dezelfde output-vorm. De laatste paar jaar waren ze uit elkaar gedreven, en de drift was van het soort dat zich opstapelt: een fix die in één repo landde landde niet altijd in de andere, en hoe langer dat doorging, hoe duurder het opnieuw op één lijn brengen zou worden.
Dus heb ik het alignment-werk eerst gedaan, voordat ik in de tussentijd opgehoopte open user-issues op de individuele repositories oppakte. Dat is niet de meest user-responsive keuze die ik had kunnen maken — er staan issues in de trackers die het niet in v2.0.0 hebben gehaald — maar het alternatief was elke issue over drie driftende libraries fixen en die daarna alsnog opnieuw alignen. De v2.0.0-audit en het v2.0.0-bench-werk nu eerst doen betekent dat vanaf hier één library fixen en de familie weer op één lijn brengen kleiner werk is dan het zou zijn geweest om alle drie vanaf een v1-startpunt te alignen.
Een opmerking over wat v2.0.0 niet is. Dit zijn geen nieuwe libraries. ta.py en ta.go zijn bestaande libraries naast ta.js die al een tijd deel uitmaken van de familie — wie er eentje gebruikte gebruikte tot nu toe de v1-tijdperk-versie. v2.0.0 is de release die ze omhoog brengt naar een gedeelde geauditeerde specificatie, met een gedeelde bench-methodologie, en ze voor het eerst onder hetzelfde versienummer uitbrengt. Het is voor het eerst dat de drie libraries van begin tot eind met elkaar in lijn zijn.
Eerlijke kanttekeningen
Dingen waarvan ik weet dat ze nog niet helemaal kloppen aan de v2.0.0-release. Niet als footer; als het deel van de post dat de rest pas geloofwaardig maakt.
Nog geen externe cross-validatie. De bench-harness komt mee in elke repository, de hardware staat gespecificeerd, de concurrent-versies zijn gepind, en iedereen die de repos cloned kan de vergelijking zelf opnieuw draaien. Ik hoop dat iemand dat doet. Op dit moment is de enige persoon die de v2.0.0-cijfers heeft gedraaid ikzelf, en de post is deels een oproep om daar verandering in te brengen. Als je de bench draait en jouw cijfers het oneens zijn met die van mij — op andere hardware, op een andere runtime-versie, met een andere competitor-versie — open een issue. Ik kom er liever nu achter dan nadat de cijfers daar al hadden gestaan alsof iedereen het ermee eens was.
De Python-bench is niet hetzelfde soort bewijs als de ta.js-bench. Er bestaat geen breed-gebruikte pure-Python TA-library om ta.py naast te zetten zoals ta.js pure-JS-peers heeft, dus de vergelijking die de bench-sectie trekt — pure-Python-tegen-pure-Python — is een houding over hoe een eerlijke benchmark er überhaupt uit zou zien, geen 66-van-67 tegen een benoemd veld. Als dat is waar je voor las, dan heeft de Python-bench dat niet.
De Rate of Change-indicator op ta.js zit op 100k bars zo’n 22% achter @debut/indicators. Ik heb hem zo uitgebracht in plaats van v2.0.0 ervoor op te houden omdat de rest van de cross-library winsten al uitvoerig waren en het gat op roc een constant-factor is dat ik in een latere ronde dicht kan rijden. “Wint 66 van 67” leest slechter dan “wint ze allemaal”, maar ik geef de voorkeur aan 66 van 67 eerlijk uitbrengen boven die 67e dramatiseren door de release op de plank te laten liggen. Er zijn nog een paar andere indicators in de familie in vergelijkbare vorm — kleine genoeg marges dat de volgende ronde perf-werk ze zou moeten kunnen wegpoetsen. Ik probeer ze uiteindelijk allemaal te verslaan in plaats van te doen alsof ik dat al doe.
De handonderhouden legacy-minified bundle voor ta.js — degene die ouder is dan de esbuild-pipeline — komt nog steeds mee met het package. Dat is geen drift-valstrik zoals het er van buitenaf uit zou kunnen zien. Het is een bewuste backwards-compatibility-toezegging aan mensen die dat bestand nog steeds van een CDN trekken in browser-apps die al jaren draaien. Hem verwijderen zou die apps stil breken, en de kosten van dat bestand erbij houden zijn kosten die ik graag betaal. De twee esbuild-gegenereerde bundles zijn het moderne pad; het legacy-bestand is het bestaande-gebruikers-niet-breken-pad.
De audit gebeurde alleen omdat de v1-test-suite me eigenlijk niet vertelde wanneer een indicator fout zat. Het is terecht om te vragen waarom dat zo lang duurde om aan het licht te komen, en het eerlijke antwoord is dat de suite groen bleef en ik die langer vertrouwde dan ik had moeten doen. Sommige van de indicators die de suite als correct certificeerde waren al fout sinds de eerste commit erop. Dat is het soort fout dat je niet ziet door alleen naar de test-runner-output te kijken, omdat de runner je al vertelt dat alles in orde is. Je vangt het door de indicators naast het leerboek te lezen, en dat is een aparte pass die pas in v2.0.0 plaatsvond.
Waar het nu staat, en wat er volgt
ta.js, ta.py en ta.go zijn alle drie live op v2.0.0 en in onderhouds-modus. Ik plan op dit moment geen golf van nieuwe functies op een van de drie. Wat ik wel plan, over de komende maanden, is om door de open issues heen te werken die op de individuele repositories zijn opgehoopt en die het niet in v2.0.0 hebben gehaald. Het patroon wordt sequentieel: fix de library met de meest dringende stapel issues, lijn alle drie weer uit zodat de fixes de familie niet opnieuw uit elkaar laten drijven, ga naar de volgende library, herhaal. Dat is volgens mij de onderhouds-vorm die een multi-language familie daadwerkelijk gezond houdt zonder meer tijd aan alignment-werk dan aan de echte fixes te besteden.
De bench-harness komt mee in elke repo en is bedoeld om daar te blijven leven als forcing function, niet alleen als het artefact achter de v2.0.0-claims. Toekomstige performance-rondes draaien tegen deze. Toekomstige correctheids-fixes worden gevalideerd tegen dezelfde fixtures die de audit heeft opgeleverd. Als de volgende keer dat iemand een issue indient “deze indicator geeft een andere output op deze input” is, geven de regeneration-from-textbook-fixtures en de cross-library-bench me de mogelijkheid om de melding tegen meerdere andere library-implementaties van diezelfde functie te checken. Die triangulatie is wat de bench de moeite waard maakt om als onderdeel van het project mee te dragen in plaats van hem maar één keer voor de aankondiging te draaien.
Als je een van deze libraries op zijn v1-tijdperk-versie hebt gebruikt, dan is de migratie naar v2.0.0 op de formules die de audit heeft gefixt breaking. De output van de indicators die bugs hadden is veranderd, omdat de bugs weg zijn. Daar is geen migratie-script voor — iedereen wiens code de v1-tijdperk-output van die indicators consumeert moet kijken of zijn code afhing van het juiste of het verkeerde antwoord. De release notes in elke repo dragen de lijst. Was je gebruik op indicators die de audit niet heeft gemarkeerd, dan is v2.0.0 een drop-in.
Wat ik eigenlijk uit deze aankondiging wil halen, is dat iemand anders dan ik de bench draait. De cijfers zijn reproduceerbaar. De hardware staat gespecificeerd. De concurrent-versies zijn gepind. Als je een TA-library in een van deze drie talen beheert of gebruikt en je geeft erom dat de vergelijking eerlijk is, dan zit de bench al in de repository en is hij met één commando te draaien. Wat je ook vindt — eens met me, oneens met me, of iets aanstippen dat ik gemist heb — is de input die ik het meeste wil voor v2.0.x. Ik probeer niet de enige persoon te zijn die deze vergelijking met cijfers heeft vastgelegd. Ik probeer de eerste te zijn.
Lees ook
-
Honderd technische indicator-functies in JavaScript
ta.js bestaat sinds 24 augustus 2020 en kreeg deze week v1.17.0. De eerlijke lezing waarom JavaScript verkeerd was voor de backtest en goed voor de chart.
-
Spec-driven development wordt steeds trager
De volledige spec-and-review-ceremonie bij elke taak vertraagde de build tot een slakkengang, dus heb ik superpowers geforkt in twee snelheidsbanen. De audit plakte er een concreet getal op: 27 subagent-runs voor 11 taken, waarbij één fix-loop 22 procent daarvan opslokte. Upstream bracht een dag na mijn routing-aanpassing een eigen router uit, dus het probleem was reëel.
-
Twee weken agentic coding in een paywalled SaaS-categorie
Ik heb Hourly in twee weken met agentic coding gebouwd om te testen of een paywalled SaaS-categorie — WorkingHours, Toggl, Timery — nog verdedigbaar is.